
إذا رفعت صورة لفاتورة أو لوحة إرشادية أو رسم بياني إلى أحد المساعدات الذكية الحديثة وسألته عنها، فستحصل غالبًا على وصف أو تفسير معقول. هذه القدرة على الجمع بين النص والصورة، وأحيانًا الصوت والفيديو، تُعرف بتعدد الوسائط، وهي من أهم التحولات في الذكاء الاصطناعي خلال السنوات الأخيرة.
تهم هذه النماذج القارئ العربي لأنها تفتح استخدامات يومية مباشرة: ترجمة لافتة أثناء السفر، وفهم مستند مصور، ومساعدة ذوي الإعاقة البصرية على التعرف إلى محيطهم، إلى جانب تطبيقات أوسع في الصناعة والأمن وصناعة المحتوى.
من التعرف على الأشياء إلى فهم المشهد
بدأت الرؤية الحاسوبية بمهام محددة: هل في الصورة قطة أم كلب؟ أين يقع الوجه؟ ما النص المكتوب؟ كانت كل مهمة تحتاج إلى نموذج مدرب خصيصًا لها. أما النماذج متعددة الوسائط الحديثة فتتعامل مع الصورة كما تتعامل مع النص، فتحولها إلى تمثيل رقمي يمكن ربطه باللغة، ثم تجيب عن أسئلة مفتوحة حولها.
الفرق جوهري: النموذج لم يعد يكتفي بتسمية العناصر، بل يحاول فهم العلاقات بينها، مثل من يفعل ماذا، وما الذي يبدو غير مألوف في المشهد، وكيف ترتبط الصورة بسؤال المستخدم.
ويتحقق ذلك عبر تدريب النموذج على أعداد كبيرة من الصور المقترنة بأوصاف نصية، فيتعلم أن أنماطًا بصرية معينة ترتبط بكلمات ومفاهيم بعينها. وبهذا يمكنه أن يجيب عن سؤال لم يُدرَّب عليه مباشرة، مثل مقارنة صورتين أو شرح خطوات وصفة من صورة مكوناتها، أو قراءة رسم بياني وتلخيص اتجاهه العام.
الفيديو: تحدي الزمن
فهم الفيديو أصعب من فهم الصورة الواحدة، لأنه يضيف بُعد الزمن. فالنموذج يحتاج إلى تتبع ما يتغير من لقطة إلى أخرى، وربط الحركة بالصوت والنص المصاحب. ولأن معالجة كل إطار مكلفة، تعتمد الأنظمة عادة على اختيار لقطات ممثلة وتلخيصها، وهو ما قد يفوّت أحيانًا تفاصيل سريعة.
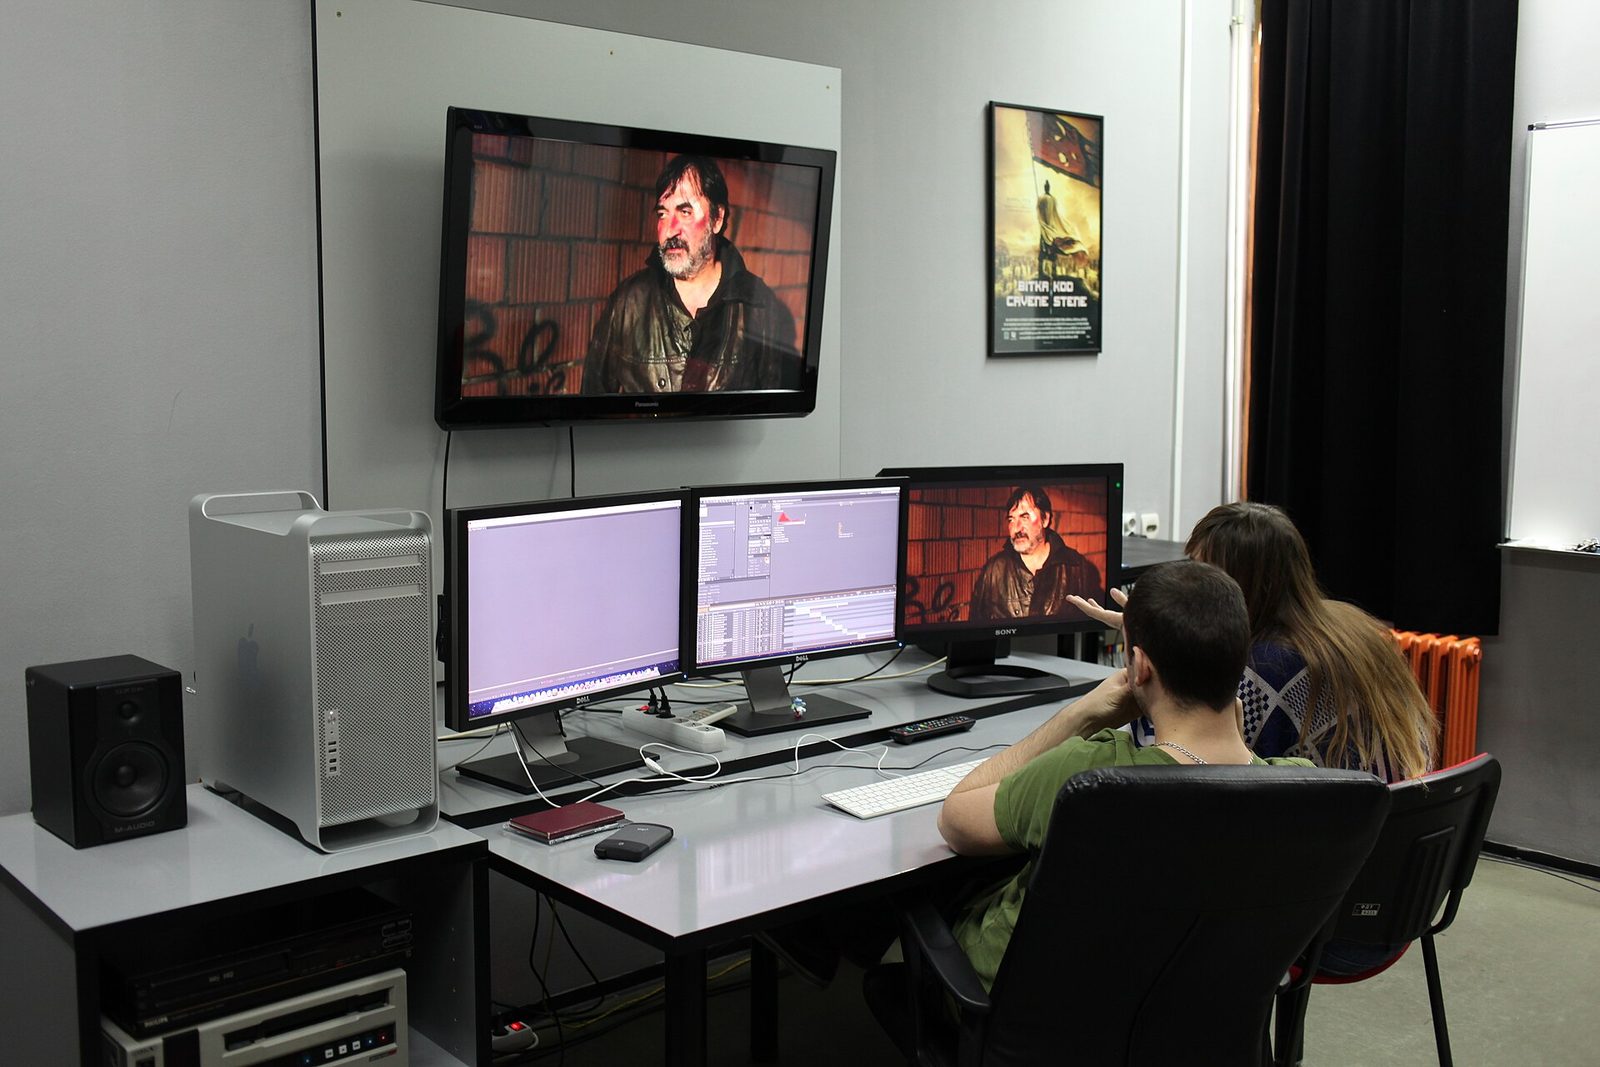
ومع ذلك فالتقدم في هذا المجال واضح: صار بالإمكان سؤال النموذج عن لحظة محددة في مقطع طويل، أو طلب تلخيص محاضرة مصورة، أو استخراج الخطوات من فيديو تعليمي، وهي مهام كانت تتطلب سابقًا مشاهدة كاملة ومراجعة يدوية.
أين نرى هذه القدرات اليوم؟
- الهواتف الذكية: البحث في معرض الصور بالوصف، ونسخ النصوص من الصور، وترجمة اللافتات عبر الكاميرا.
- إمكانية الوصول: وصف الصور والمحيط للمستخدمين المكفوفين وضعاف البصر.
- صناعة المحتوى: توليد الترجمات المصاحبة، والبحث داخل أرشيف الفيديو، واقتراح المقاطع الأبرز.
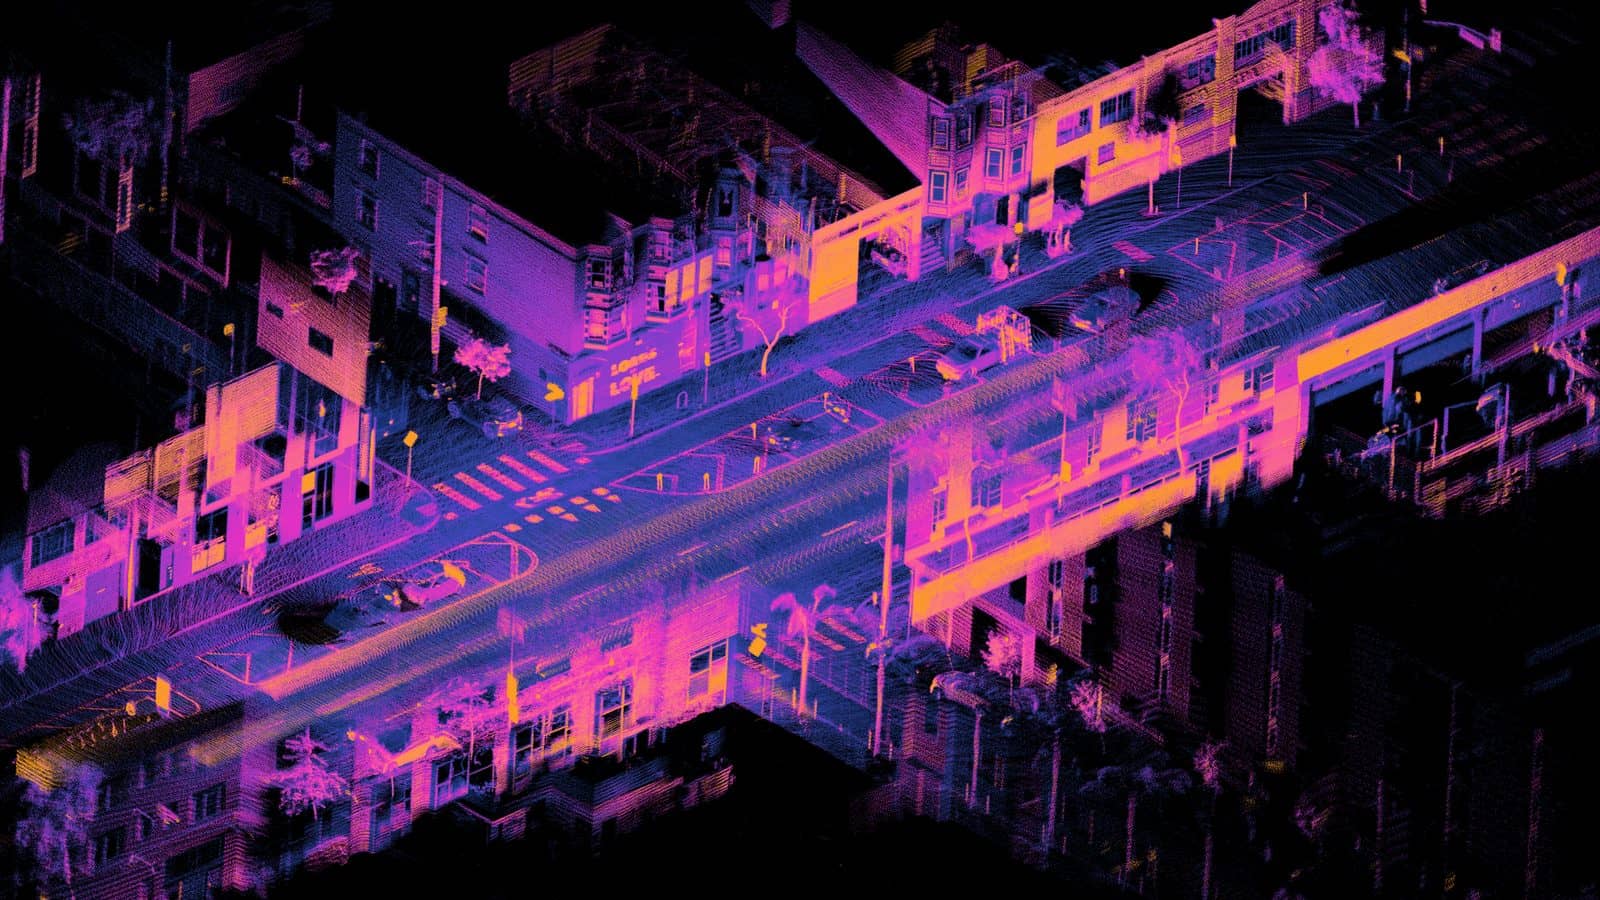
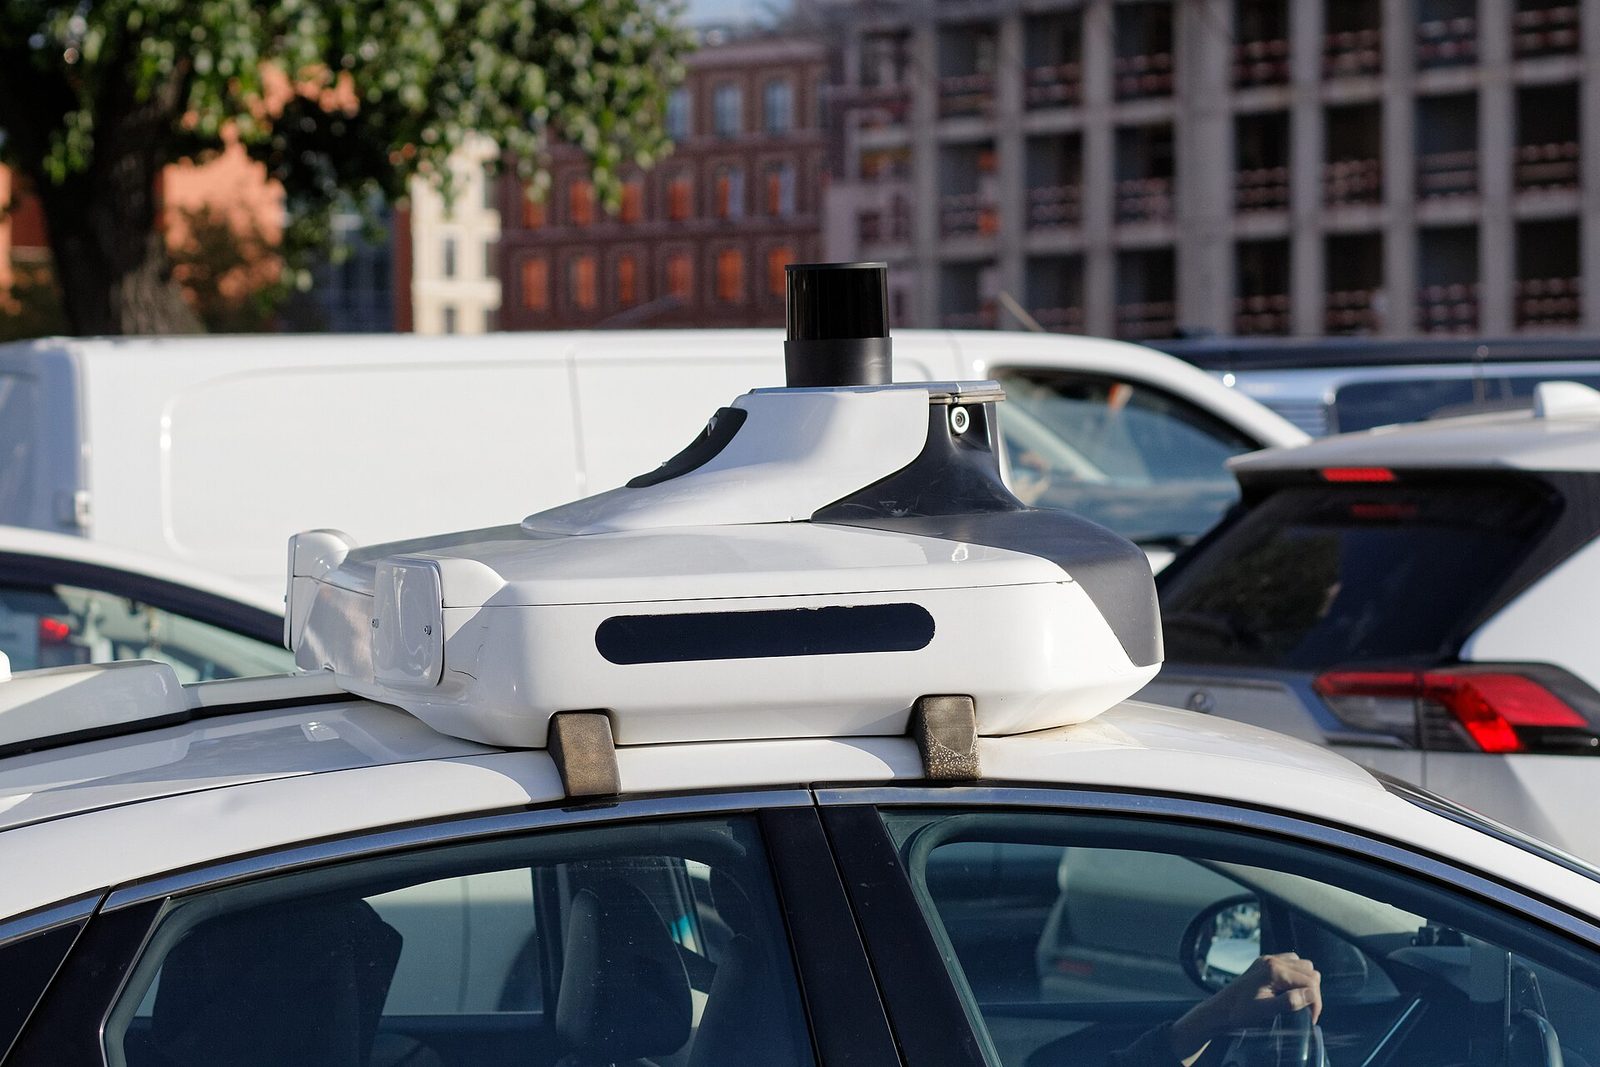
- النقل: أنظمة مساعدة السائق والسيارات ذاتية القيادة التي تجمع بين الكاميرات ومستشعرات أخرى مثل الليدار.
- الصناعة والزراعة: رصد العيوب في خطوط الإنتاج ومتابعة حالة المحاصيل.
حدود لا يجب تجاهلها
رغم التقدم الكبير، ما زالت هذه النماذج تخطئ في عد العناصر الصغيرة، وقراءة الخطوط العربية المزخرفة أو المكتوبة باليد، وفهم السياق الثقافي لصورة ما. وقد تصف تفاصيل غير موجودة أصلًا إذا كانت الصورة غامضة أو منخفضة الجودة.
النموذج يرى البكسلات، أما المعنى الكامل للصورة فما زال يحتاج في أحيان كثيرة إلى عين بشرية.
وتثير القدرة على تحليل الصور والفيديو على نطاق واسع مخاوف جدية تتعلق بالخصوصية والمراقبة والتعرف على الأشخاص دون موافقتهم، وهي قضايا تتعامل معها التشريعات بدرجات متفاوتة من بلد إلى آخر.
كيف تستفيد منها بحكمة؟
- استخدمها لاستخراج النصوص وتلخيص المحتوى المرئي، ثم راجع النتيجة.
- لا ترفع صورًا لوثائق رسمية أو بطاقات بنكية أو صور لأشخاص دون إذنهم.
- اطلب من الأداة توضيح ما لم تتأكد منه بدل الاكتفاء بالإجابة الأولى.
- في الاستخدامات المهنية، اختبر الأداة على عينات من بياناتك الفعلية قبل الاعتماد عليها.
نرى أن فهم الصور والفيديو سيصبح قريبًا جزءًا عاديًا من أي مساعد ذكي، تمامًا كما أصبح فهم النص. والمستخدم الواعي بحدود هذه القدرات سيجني فوائدها دون أن يقع في أخطائها.